robots.txt para robôs de IA
Quais robôs existem, o que cada um faz, exemplos de regras para separar treino de busca e as armadilhas que fazem a regra não funcionar.
Neste texto
Para quem é este guia
Para quem administra um site e precisa decidir quem pode rastrear o quê. O nível é intermediário: você precisa editar o robots.txt na raiz do domínio e ler logs de acesso. Pré-requisito: saber que o robots.txt é um pedido de cortesia feito a robôs, padronizado na RFC 9309, e que a própria RFC diz que essas regras não são uma forma de autorização de acesso. O Google acrescenta que o arquivo não serve para manter uma página fora dos resultados de busca; para isso há noindex ou proteção por senha.
Quais robôs existem e o que cada um faz?
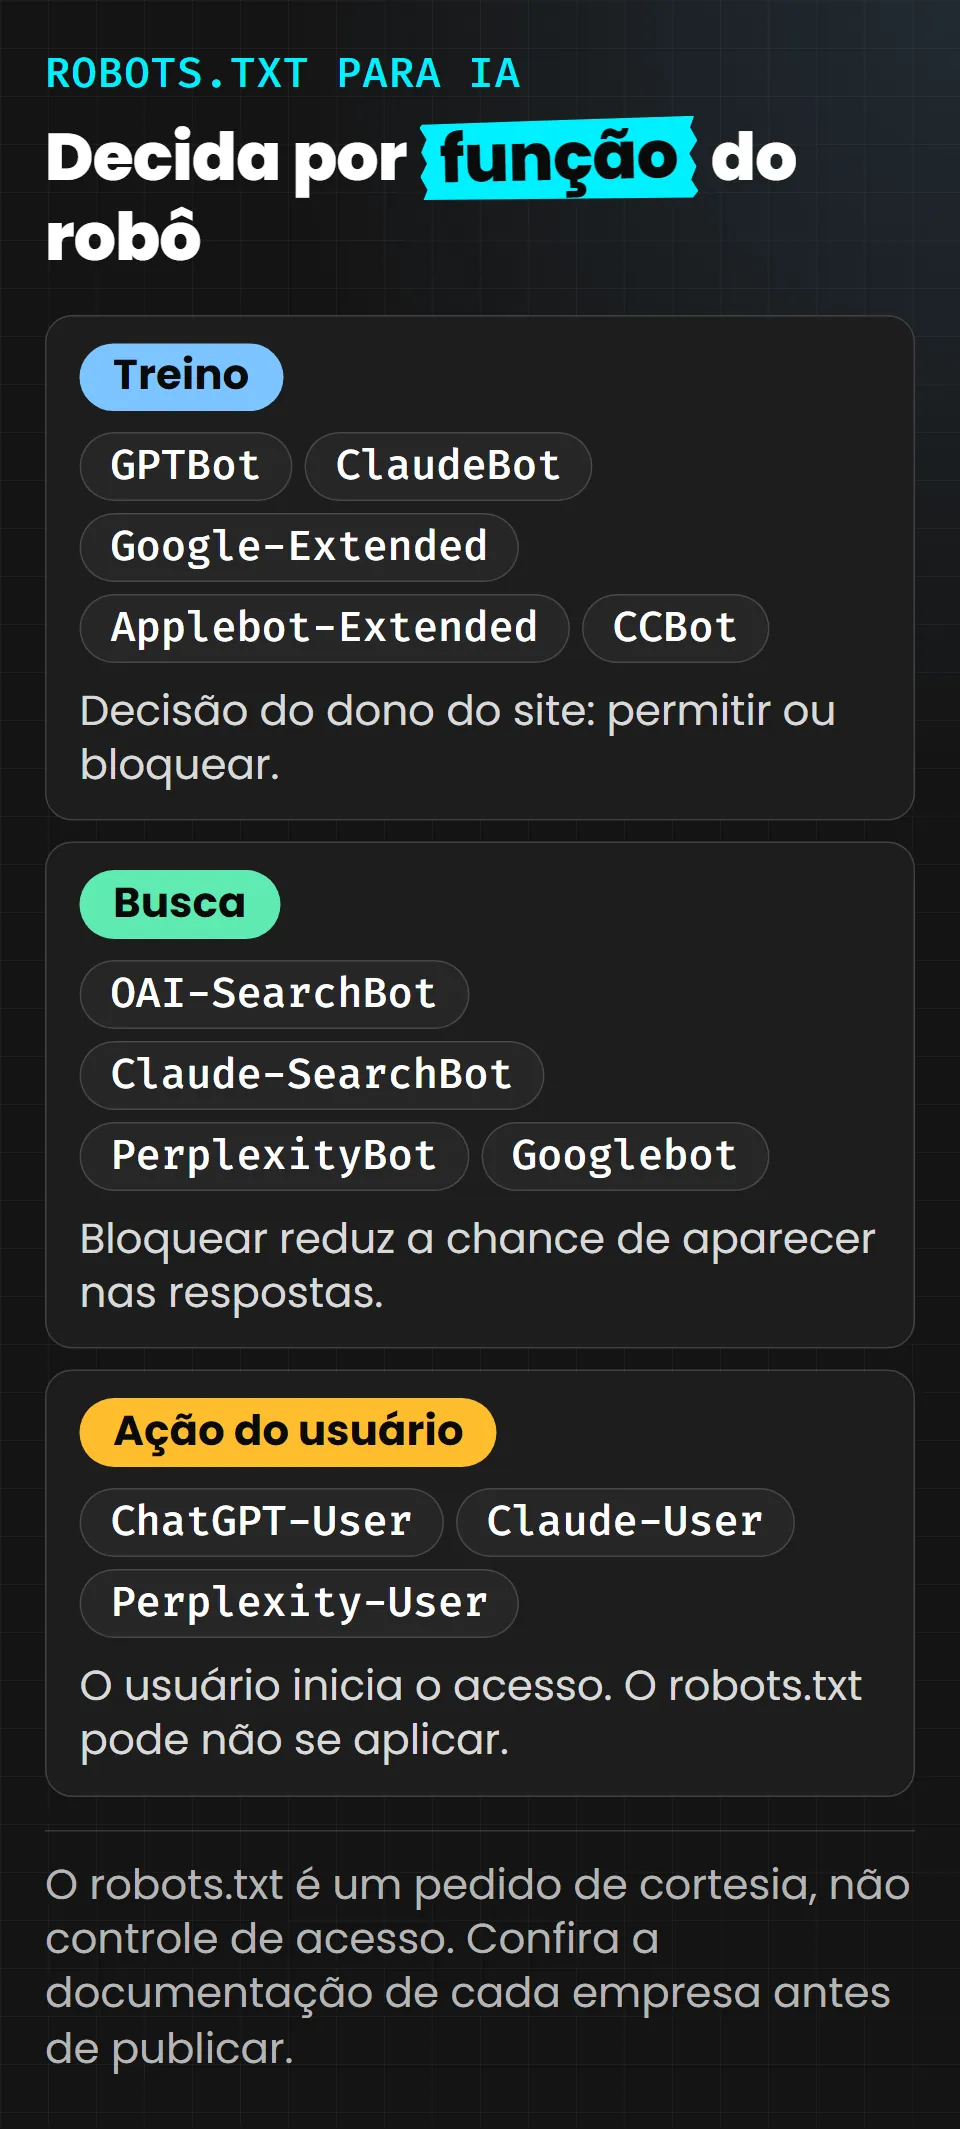
A tabela reúne os robôs descritos na documentação oficial de cada empresa, consultada em 14 de outubro de 2026. Os tokens são os nomes usados na linha User-agent do robots.txt.
| Empresa | Token | Função informada pela empresa | Observação da documentação |
|---|---|---|---|
| OpenAI | GPTBot | coleta de conteúdo que pode ser usado para treinar modelos de fundação | bloquear sinaliza que o conteúdo não deve ser usado em treino |
| OpenAI | OAI-SearchBot | exibir sites nos recursos de busca do ChatGPT | quem o bloqueia não aparece nas respostas de busca, mas pode aparecer como link de navegação |
| OpenAI | ChatGPT-User | ações iniciadas por usuários no ChatGPT, como visitar uma página a pedido | como é o usuário quem inicia, as regras do robots.txt podem não se aplicar |
| Anthropic | ClaudeBot | coleta de conteúdo que pode contribuir para o treino dos modelos | aceita Crawl-delay como extensão não padronizada |
| Anthropic | Claude-User | acessar sites quando um usuário faz uma pergunta ao Claude | desativar pode reduzir a visibilidade em buscas dirigidas pelo usuário |
| Anthropic | Claude-SearchBot | melhorar a qualidade dos resultados de busca | desativar pode reduzir visibilidade e precisão nesses resultados |
| Perplexity | PerplexityBot | exibir e linkar sites nos resultados do Perplexity | segundo a empresa, não é usado para treinar modelos de fundação |
| Perplexity | Perplexity-User | visita a página para responder a uma pergunta do usuário | a empresa diz que, em geral, ignora o robots.txt por ser uma solicitação do usuário |
| Googlebot | rastreamento da Busca, usado também pelos recursos de IA da Busca | a regra do Googlebot é o controle de acesso para a Busca | |
| Google-Extended | token de controle para uso de conteúdo no treino de futuros modelos Gemini e em grounding no app Gemini e na Vertex AI | segundo o Google, não afeta a inclusão nem o ranking na Busca; não é um user agent separado | |
| Apple | Applebot | alimenta buscas no Spotlight, Siri e Safari | pode ajudar a treinar modelos de fundação da Apple |
| Apple | Applebot-Extended | controla o uso, para treino, do conteúdo que o Applebot já rastreou | não rastreia páginas; bloquear não afeta a Busca da Apple |
| Common Crawl | CCBot | rastreia a web para um repositório aberto de dados | regra de bloqueio por User-agent: CCBot |
A OpenAI informa que, se um site permite OAI-SearchBot e GPTBot, os resultados de um rastreamento podem ser usados para as duas finalidades. A Anthropic recomenda editar o robots.txt em vez de bloquear por IP, porque o bloqueio de IP pode impedir a leitura do próprio arquivo. Os endereços de cada robô são publicados pelas empresas em arquivos JSON que servem para verificar se uma requisição é legítima.
Exemplo 1: permitir busca e leitura sob demanda, bloquear treino
Este é o arranjo mais citado por quem quer ser encontrado em respostas de IA sem permitir o uso para treino. A decisão é do proprietário do site.
# Robôs de busca e de leitura sob demanda: permitidos
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Perplexity-User
Allow: /

# Robôs de treino: bloqueados
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: CCBot
Disallow: /

# Regras gerais
User-agent: *
Allow: /

Sitemap: https://exemplo.com.br/sitemap.xml
Exemplo 2: permitir tudo, inclusive treino
É a escolha deste site. Quem produz conteúdo para ser citado e aceita seu uso em treino pode manter o acesso aberto. O robots.txt de llmseeding.org registra essa decisão.
User-agent: *
Allow: /

Sitemap: https://exemplo.com.br/sitemap.xml
Exemplo 3: bloquear os robôs de IA e manter a Busca tradicional
Quem não quer aparecer em respostas de IA nem ser usado em treino pode bloquear todos os tokens de IA, mas isso reduz a chance de aparecer em assistentes. O Googlebot permanece liberado.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
Vários User-agent seguidos formam um único grupo que compartilha as regras abaixo. Nota: ChatGPT-User, Claude-User e Perplexity-User tratam de pedidos do usuário. A documentação da OpenAI e da Perplexity diz que o robots.txt pode não se aplicar a eles. Para barrar esse acesso, a ferramenta é o controle no servidor ou no firewall, e não o robots.txt.
Exemplo 4: proteger só algumas áreas
User-agent: GPTBot
Disallow: /area-do-cliente/
Disallow: /rascunhos/

User-agent: OAI-SearchBot
Disallow: /area-do-cliente/
Para dados realmente privados, o robots.txt não basta. Use autenticação. O arquivo é público: quem lê as suas regras vê a lista do que você pede para não rastrear.
Quais armadilhas fazem a regra não funcionar?
O grupo específico substitui o grupo geral. A RFC 9309 diz que o robô usa o grupo que corresponde ao seu token e, se nenhum corresponde, usa o grupo *. Se você mantém regras sob User-agent: * e cria um grupo só para OAI-SearchBot, esse robô passa a seguir apenas o grupo dele e deixa de seguir as regras do *. Repita as restrições necessárias em cada grupo.
O token precisa estar correto. A correspondência não diferencia maiúsculas de minúsculas, mas diferencia o nome. Um erro de digitação cria uma regra que ninguém lê.
Mudanças levam tempo. A OpenAI informa que alterações levam cerca de 24 horas para refletir na busca, e a Perplexity informa até 24 horas. Não conclua que a regra falhou uma hora depois.
CDN e firewall podem bloquear mesmo com o robots.txt liberando. Teste os acessos nos logs e verifique se o robô recebe status 200 na página e no próprio robots.txt.
Bloquear o Googlebot afeta a Busca e os recursos de IA. O Google diz que a regra do Googlebot é o controle de acesso para esses recursos. Bloquear o Google-Extended não afeta a Busca.
O arquivo não impede acesso de robôs que o ignoram. Alguns rastreadores não obedecem. O Google lembra que as instruções do robots.txt não conseguem impor o comportamento do robô.
Páginas bloqueadas ainda podem aparecer como link. Para impedir a exibição, use noindex em página que o robô consiga ler, e nunca combine noindex com bloqueio de rastreamento.
Qual decisão tomar sobre treino?
Não há resposta única. Argumentos para bloquear: controle sobre o uso do conteúdo, preocupação com direitos autorais, política editorial. Argumentos para permitir: o conteúdo é de interesse público, o objetivo é ser compreendido pelos modelos, o custo de bloqueio supera o ganho. Bloquear treino não impede a citação, desde que os robôs de busca estejam liberados. Permitir treino não garante nenhuma citação, porque o treino não é consulta. O método trata o acesso como pré-requisito e deixa a escolha de treino ao proprietário, com a decisão registrada em algum lugar visível da equipe.
Para o comparativo de robôs de treino e de busca em formato de glossário, veja o material em seogeo.site. Para um material de apoio do autor sobre o tema, existe a página de robôs e bots de IA.
Como testar e medir
- 01Abra seudominio.com.br/robots.txt no navegador e confirme que o arquivo responde com status 200 e texto simples.
- 02Confira a sintaxe: cada grupo começa com
User-agent, as regras vêm logo abaixo, linhas em branco separam grupos. - 03Verifique nos logs do servidor, por semana, quais robôs de IA acessaram, com que status e quais caminhos. Valide os IPs com os arquivos JSON publicados pelas empresas.
- 04Teste uma página-chave com os mesmos robôs se possível: o conteúdo principal precisa estar no HTML entregue, não só carregado depois por script.
- 05Registre a data de cada alteração e compare, nas semanas seguintes, o resultado do conjunto fixo de perguntas descrito em ROI sem clique.
Critério de sucesso: os robôs que você quer permitir acessam as páginas-chave com status 200, os que você bloqueia deixam de rastrear em alguns dias e nenhuma regra geral foi substituída sem querer.
Depois de ajustar o arquivo, confira o restante da base no checklist e veja como o método trata o acesso como pré-requisito. A página erros comuns lista o bloqueio acidental como o primeiro erro a verificar.
Perguntas frequentes
Bloquear o GPTBot impede que o ChatGPT cite meu site?
Não necessariamente. Segundo a OpenAI, o GPTBot trata de treino e o OAI-SearchBot trata da busca do ChatGPT. Quem libera o segundo e bloqueia o primeiro pode aparecer nas respostas de busca sem permitir o uso em treino. A empresa nota que os rastreamentos podem ser compartilhados entre os dois quando ambos estão liberados.
O Google-Extended afeta meu posicionamento no Google?
Segundo o Google, não. O token controla o uso do conteúdo no treino de futuros modelos Gemini e no grounding em produtos como o app Gemini, e não influencia a inclusão nem o ranking na Busca. A Busca é controlada pelas regras do Googlebot.
Posso confiar que o robots.txt impede cópia do meu conteúdo?
Não. O arquivo é um pedido a robôs que o respeitam. A RFC 9309 afirma que as regras não são uma forma de autorização de acesso. Para controle real, use autenticação, limites no servidor ou serviços de proteção.
Fontes
- Overview of OpenAI crawlers, OpenAI (2026-10-14)
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic (2026-04-07)
- Perplexity crawlers, Perplexity (2026-10-14)
- Google's common crawlers, Google Search Central (2026-07-14)
- About Applebot, Apple (2026-10-14)
- CCBot, Common Crawl (2026-10-14)
- RFC 9309: Robots Exclusion Protocol, IETF (2022)
- Robots.txt Introduction and Guide, Google Search Central (2025-12-10)
Datas de documentos sem publicação indicada correspondem ao acesso em 14/10/2026. Tokens e comportamentos podem mudar. Última revisão: 14/10/2026.
Comece pelo checklist
Dezoito verificações em seis grupos para saber se o seu conteúdo pode ser compreendido, verificado e citado.