llms.txt funciona?
O que o formato propõe, o que Google e estudos independentes dizem sobre efeito em citações e quando vale criar o arquivo mesmo assim.
Neste texto
O que é o llms.txt, segundo quem o propôs?
O llms.txt foi proposto por Jeremy Howard e publicado em 3 de setembro de 2024. É um arquivo em Markdown na raiz do site que oferece a sistemas de linguagem um resumo curto e uma lista comentada de links para as páginas mais úteis. O formato prevê um título (H1), um bloco de resumo (citação), textos opcionais e seções (H2) com listas de links, incluindo uma seção "Optional" para o que pode ser ignorado quando o contexto é curto.
A proposta é explícita sobre o uso pretendido: o arquivo seria útil principalmente no momento da inferência, quando um agente ajuda uma pessoa, e não para treino. Ele é diferente do robots.txt, que trata de acesso. O texto da proposta afirma que milhares de sites o publicam e que algumas empresas o usam em documentação para desenvolvedores. São afirmações do autor da proposta, que esta página não verificou.
O que o Google diz?
Em 17 de junho de 2025, John Mueller, do Google, escreveu em uma rede social que nenhum sistema de IA usava o llms.txt, resposta noticiada pelo Search Engine Roundtable. Em 2026, a posição passou a constar em documentação oficial. O guia "Optimizing your website for generative AI features on Google Search", atualizado em 10 de julho de 2026, afirma que o Google Search não usa arquivos de texto específicos para IA, que não é preciso criá-los para aparecer nos recursos de IA e que fazê-lo não prejudica nem ajuda a visibilidade ou o ranqueamento na Busca, porque ela os ignora. O mesmo guia diz que não há problema em criar e manter esses arquivos para outros serviços que os usem.
Duas observações. A primeira: o que o Google diz vale para o Google Search e seus recursos de IA. Não é uma declaração sobre o ChatGPT, o Claude, o Perplexity ou o Copilot. A segunda: "ninguém usa" é uma afirmação sobre o presente e sobre o que a empresa sabe de si mesma. Ela não prova que nenhum agente de terceiros, em nenhum contexto, leia o arquivo.
O que mostram os estudos?
O estudo mais citado é da SE Ranking, empresa de ferramentas de SEO, publicado em 7 de novembro de 2025. Foram analisados cerca de 300 mil domínios, dos quais cerca de 10% tinham llms.txt. Usando correlação de Spearman e um modelo de regressão com análise de contribuição, os autores não encontraram relação mensurável entre ter o arquivo e a frequência de citações em respostas de modelos de linguagem. Ao remover a variável do modelo, a precisão melhorou, o que os autores interpretam como indício de ruído. Eles mesmos advertem que o resultado é específico do modelo e do conjunto de dados.
Pontos de cautela, em estilo de ficha:
- É estudo de fornecedor, com interesse no tema.
- É correlacional. Não prova que o arquivo é inútil em todos os casos, só que, no conjunto medido, não houve associação detectável.
- A medida de citação foi a frequência com que cada domínio aparecia como fonte nas respostas amostradas, o que depende das perguntas e plataformas escolhidas.
- Não mede o uso por agentes de código ou por assistentes que consultam documentação sob demanda.
O que se sabe e o que não se sabe?
| Afirmação | Situação |
|---|---|
| O formato foi proposto em setembro de 2024 e tem especificação pública | verificado |
| O Google Search diz que ignora o arquivo | verificado na documentação do Google, julho de 2026 |
| Há relação mensurável entre ter o arquivo e ser mais citado | não encontrada em estudo de ~300 mil domínios (fornecedor, nov. 2025) |
| Algum assistente de IA lê o arquivo ao responder usuários | não confirmado publicamente por fornecedores de assistentes consultados para esta página |
| Agentes e ferramentas de desenvolvimento podem ler o arquivo em documentação técnica | plausível e usado por sites de documentação, sem estudo de eficácia consultado |
| O arquivo pode prejudicar o site | não há indício; o Google diz que não prejudica |
Quando vale criar o arquivo?
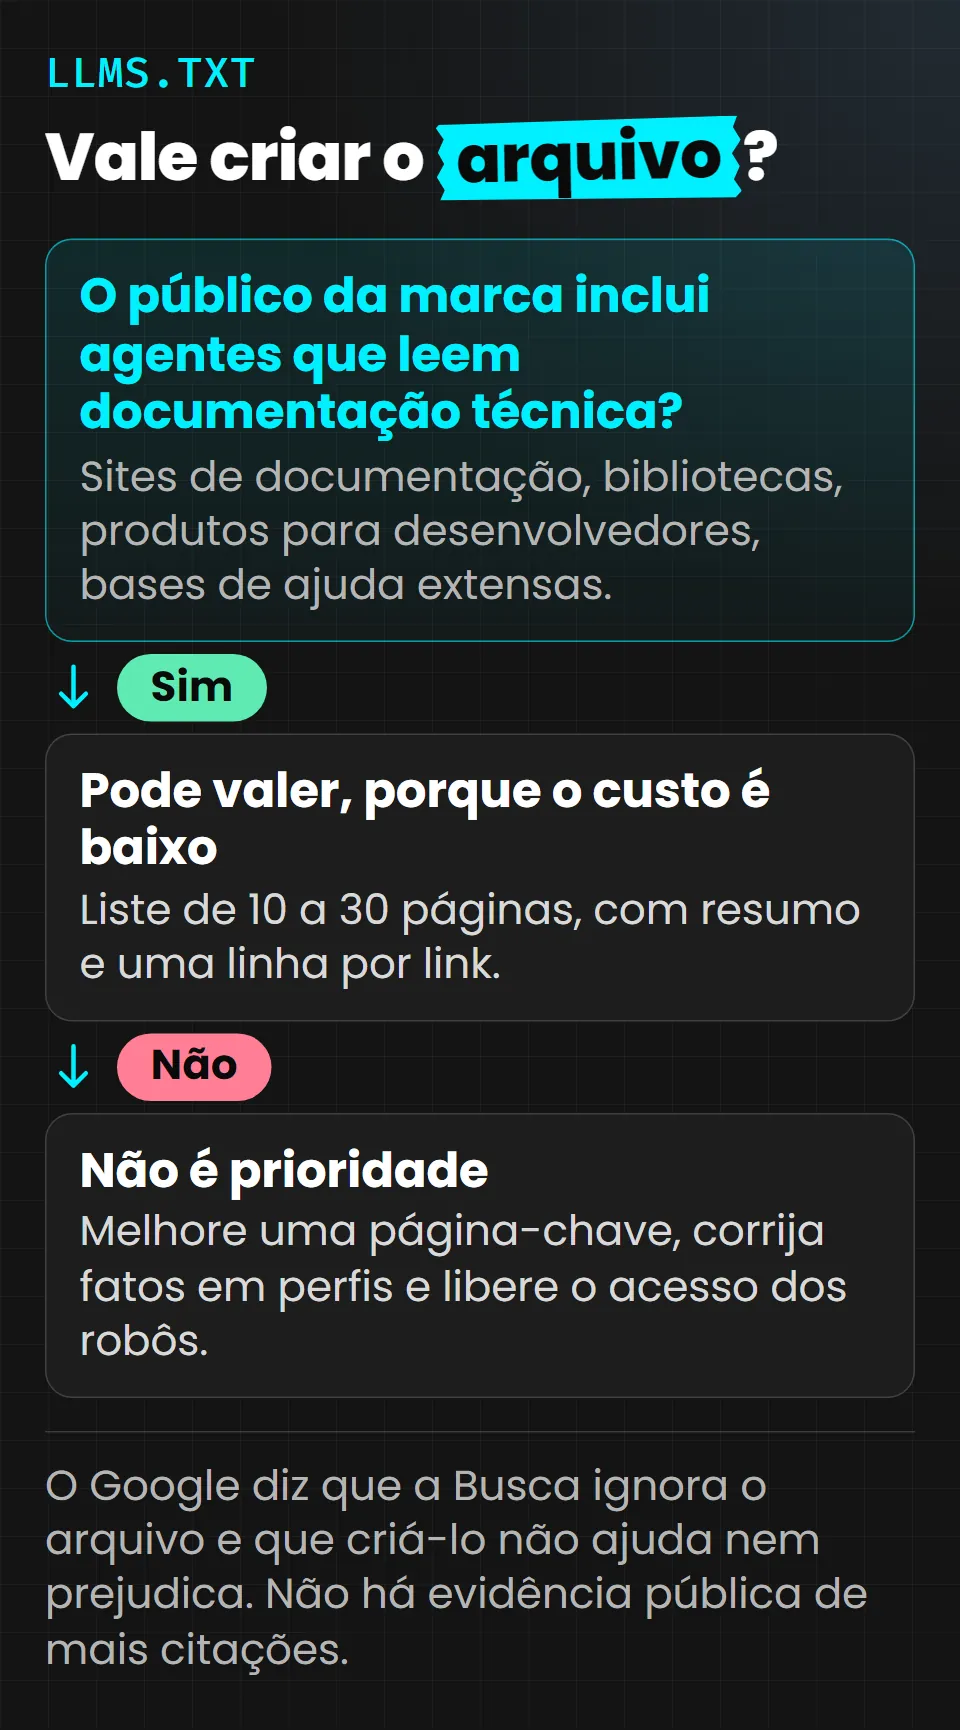
Vale quando o custo é baixo e o público inclui agentes que leem documentação: sites de documentação técnica, bibliotecas, produtos para desenvolvedores, bases de ajuda extensas. O próprio site do Model Context Protocol, por exemplo, indica na primeira linha de suas páginas a existência de um índice de documentação em llms.txt, voltado a agentes que consomem a documentação. Esse é um uso concreto e restrito.
Não vale como estratégia central de citação. Se o orçamento de tempo é pequeno, o ganho esperado de melhorar uma página-chave, corrigir fatos em perfis externos ou liberar o acesso dos robôs é maior e mais bem documentado. Este site publica um /llms.txt gerado automaticamente a partir das páginas, como experimento de custo baixo, sem expectativa de efeito.
Como criar um llms.txt, se decidir criar
- 01Liste de 10 a 30 páginas mais úteis do site, as que respondem às perguntas centrais.
- 02Escreva o título com o nome oficial da marca e um resumo de uma ou duas frases, sem superlativos.
- 03Agrupe os links por tema em seções. Cada item tem o nome da página e uma descrição de uma linha que diga o que ela responde.
- 04Coloque o arquivo em /llms.txt, na raiz do domínio, servido como texto simples.
- 05Revise quando as páginas mudarem. Link quebrado ou descrição desatualizada é pior do que não ter o arquivo.
- 06Não use o arquivo para dar ordens a modelos nem para esconder conteúdo que não está nas páginas. O que não está visível ao leitor não deve estar no arquivo.
Exemplo para uma empresa fictícia:
# Hidráulica Modelo

> Empresa de serviços de hidráulica residencial e comercial em Belo Horizonte e Contagem.

## Serviços
- [Desentupimento de esgoto](https://exemplo.com.br/desentupimento/): escopo, prazos de atendimento e o que está incluído no preço.
- [Detecção de vazamentos](https://exemplo.com.br/vazamentos/): método de inspeção e quando é indicado.

## Informações da empresa
- [Quem somos](https://exemplo.com.br/quem-somos/): responsáveis técnicos, registro e áreas atendidas.
- [Perguntas frequentes](https://exemplo.com.br/faq/): prazos, pagamento e garantia.
Quais erros evitar?
Criar o arquivo e deixá-lo parado. Escrever textos promocionais no resumo. Copiar o sitemap inteiro sem curadoria. Incluir páginas bloqueadas por robots.txt ou com noindex. Tratar o arquivo como substituto de páginas claras. Prometer a clientes que ele "coloca a marca no ChatGPT". Nenhuma fonte consultada sustenta essa promessa.
Como medir se o arquivo faz alguma diferença?
Nos logs do servidor, veja se há requisições a /llms.txt e de quais agentes. Isso mostra leitura, não efeito. Para efeito, use o conjunto fixo de perguntas descrito em ROI sem clique, antes e depois da criação, e registre as demais mudanças feitas no período. Com um único site, não é possível isolar o efeito do arquivo. Por isso a recomendação é não construir expectativa sobre ele.
Próximo passo
Se decidir criar o arquivo, o gerador e validador de llms.txt monta o texto a partir da sua lista de páginas e confere o formato no navegador. A decisão que realmente muda o acesso dos robôs é o robots.txt para robôs de IA. Para o que vem depois dos textos, ações que agentes executam em lojas e serviços, veja Web MCP e ACO. Para o verbete, o glossário de seogeo.site traz a definição resumida.
Perguntas frequentes
O llms.txt é um padrão oficial?
Não. É uma proposta publicada por Jeremy Howard em 2024, sem endosso de organismo de padronização. Existe especificação pública, mas cada plataforma decide se a usa. O Google afirma que a Busca o ignora.
Criar o llms.txt pode prejudicar meu SEO?
Segundo o Google, criar e manter o arquivo não prejudica nem ajuda a visibilidade na Busca. O risco prático é manter um arquivo desatualizado ou promocional. Se você não vai mantê-lo, não crie.
O llms.txt substitui o sitemap ou o robots.txt?
Não. O sitemap lista endereços para rastreamento e o robots.txt define regras de acesso. O llms.txt, na proposta, é um resumo comentado para uso sob demanda por agentes. Os três têm funções diferentes.
Fontes
- The /llms.txt file, llmstxt.org (Jeremy Howard) (2024-09-03)
- Optimizing your website for generative AI features on Google Search, Google Search Central (2026-07-10)
- Google: No AI System Currently Uses LLMs.txt, Search Engine Roundtable (2025-06-18)
- Does LLMs.txt impact your AI visibility and citations? (estudo de fornecedor, SE Ranking), SE Ranking (2025-11-07)
- What is the Model Context Protocol (MCP)?, modelcontextprotocol.io (2026-10-14)
Última revisão: 14/10/2026. Conclusões sujeitas a mudança: confira a documentação dos fornecedores antes de decidir.
Comece pelo checklist
Dezoito verificações em seis grupos para saber se o seu conteúdo pode ser compreendido, verificado e citado.