O método LLM Seeding
Seis etapas para transformar o que uma marca sabe sobre si mesma em informação que sistemas de IA consigam encontrar, entender e citar.
Neste texto
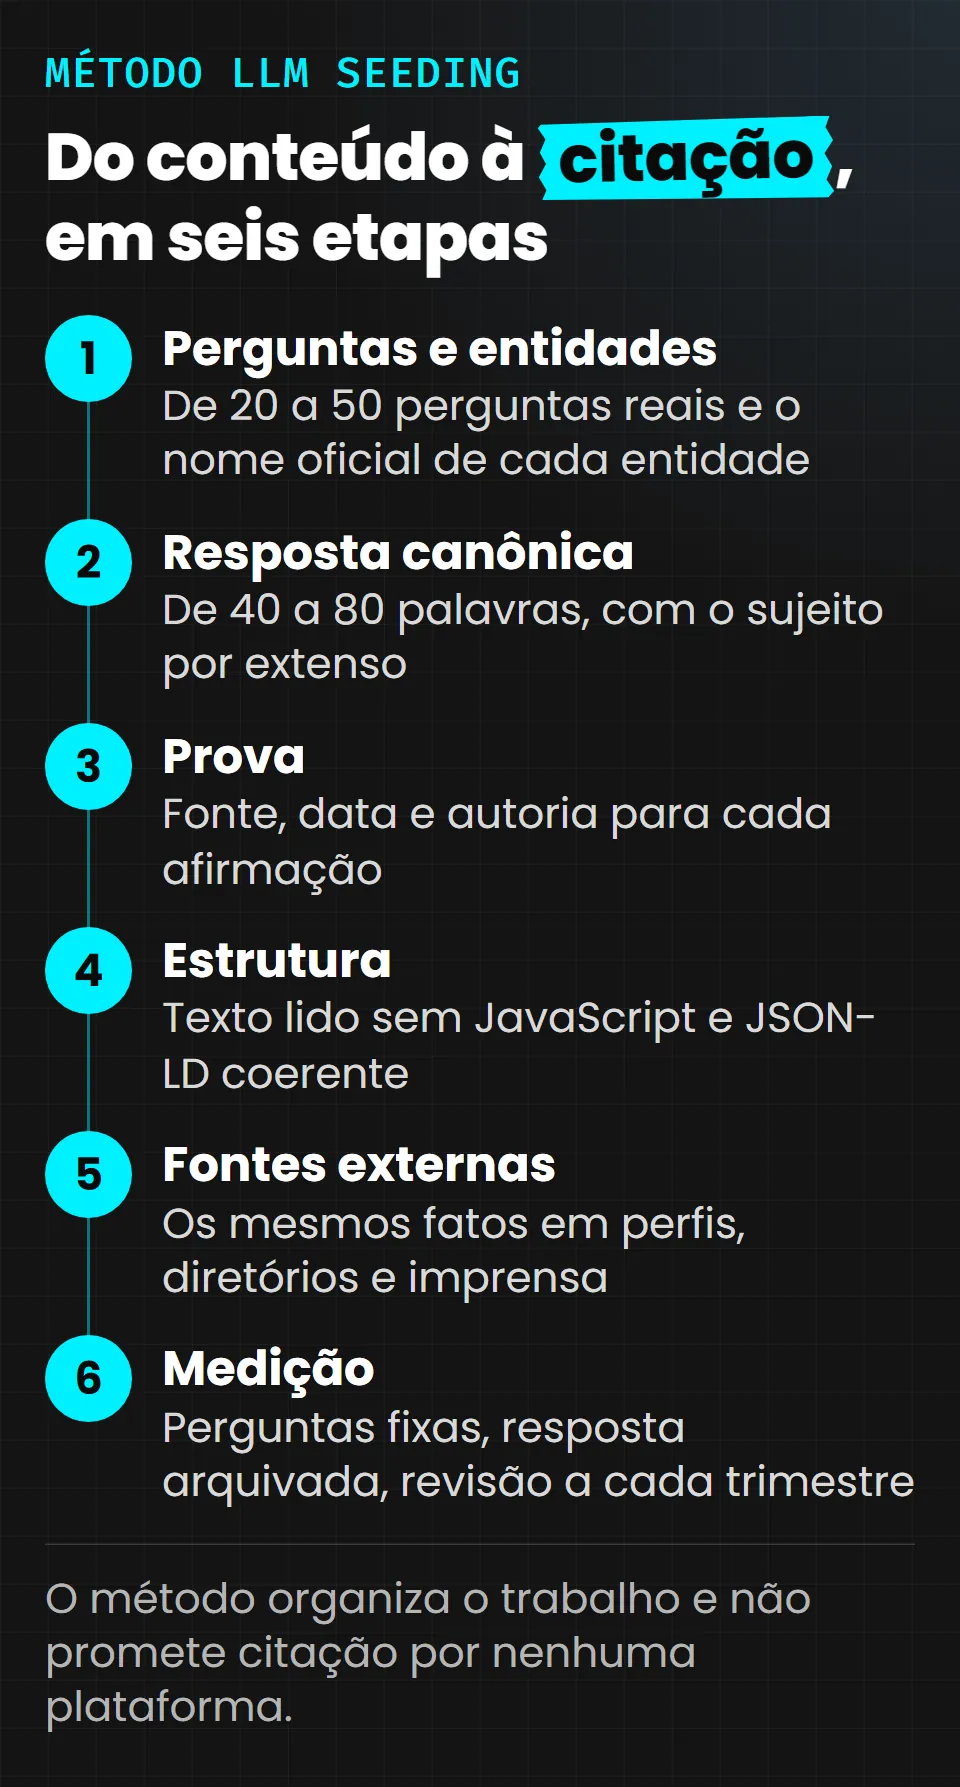
Como o método se organiza?
O LLM Seeding parte de uma observação simples. Sistemas de resposta com IA usam o que conseguem recuperar e verificar. Se a informação correta sobre uma marca está dispersa, ambígua ou sem prova, a resposta herda esses defeitos. O método ataca esses três defeitos na ordem em que eles aparecem. A definição completa fica na página-mãe; aqui estão as etapas.
Os três princípios que sustentam tudo são frases canônicas, prova e verificabilidade, e clareza para modelos. Cada etapa abaixo aplica um ou mais deles, e cada uma termina com um critério que permite dizer "feito" ou "não feito" sem opinião.
Como o método se liga aos três pilares da citação?
Antes das seis etapas, o site anterior do método resumia a citação em três pilares, e eles continuam valendo como leitura de conjunto. Estruturação: dados em HTML nativo, tabelas e listas, afirmações concisas (etapas 2 e 4). Autoridade: quem assina o conteúdo precisa ter lastro conferível em outro lugar da web (etapas 3 e 5, e a página E-E-A-T). Contexto: o negócio descrito com precisão, inclusive local, com nome, endereço e telefone consistentes (etapa 5 e por tipo de negócio). Os pilares são uma síntese editorial; o desempenho de cada um não tem peso medido.
Etapa 1: quais perguntas e quais entidades precisam estar certas?
Comece pelo que o seu cliente de fato pergunta, não pelo que você gostaria de responder. Liste de 20 a 50 perguntas reais, em linguagem natural, vindas de atendimento, vendas, Search Console, comentários e buscas relacionadas. Agrupe por intenção: definição, comparação, preço, localização, confiança, problema.
Depois liste as entidades que aparecem nessas respostas: a marca, os produtos ou serviços, as pessoas responsáveis, os lugares e os termos técnicos. Para cada entidade, anote o nome oficial, as variações de grafia, o endereço da página que a define e os fatos que não podem estar errados.
Uma pergunta complexa costuma ser dividida pelos sistemas de busca com IA em subconsultas. O Google descreve essa técnica como query fan-out. O mecanismo é conceito de mercado. O método de cobertura é de Camillo e está em queryfan-out.com. Para o LLM Seeding, basta saber que uma pergunta vira várias, e que cada uma precisa de um bloco que a responda.
Critério de sucesso: uma planilha com perguntas agrupadas, entidades com nome oficial e, para cada fato crítico, a página onde ele será definido. Se duas páginas definem o mesmo fato de modo diferente, a etapa não terminou.
Etapa 2: como escrever a resposta canônica?
A resposta canônica é a formulação oficial de um fato. Tem de 40 a 80 palavras no formato de resposta curta e começa com o sujeito nomeado por extenso. Ela responde à pergunta antes de contextualizar, resiste a ser lida sem o resto da página e traz data de revisão.
Um bom teste: copie só esse bloco e cole em uma conversa. Alguém que nunca viu a sua marca entende quem é, o que faz, onde e para quem? Se a resposta é "sim", o bloco é canônico. Se precisa do parágrafo anterior para fazer sentido, ainda não é.
Evite pronomes que dependem do contexto ("ele", "a empresa", "nosso produto"). Evite superlativos sem prova. Use a mesma frase, palavra por palavra, nos lugares em que o fato aparece, como página inicial, perfil e rodapé de imprensa. A repetição aqui serve à consistência, e não deve virar repetição de palavra-chave.
Critério de sucesso: cada pergunta crítica tem um bloco de resposta direta em uma página-casa, e o mesmo fato é idêntico em todas as superfícies controladas pela marca.
Etapa 3: o que prova cada afirmação?
Sem prova, a frase canônica é apenas uma afirmação da própria marca. A prova pode ser um documento (registro, certificação, contrato público), uma página oficial de terceiro, um dado com método e data, ou um estudo próprio com a metodologia exposta. Para cada afirmação crítica, registre qual é a prova, onde ela está, quando foi conferida e quem a conferiu.
Números pedem fonte, data e contexto. Dados com mais de doze meses levam o ano no texto. Se o número não pode ser verificado, a regra é simples: descreva a ideia sem ele. Declarações do autor entram como declarações, e não como fato auditado.
A autoria também é prova. Páginas com autor identificável, data de publicação, data de atualização e uma página de perfil que explique a experiência dão ao leitor e à máquina uma forma de avaliar a fonte. O Google fala em conteúdo "não commodity", aquele com perspectiva própria, experiência direta ou conhecimento especializado, que não repete o que já está em todo lugar.
Critério de sucesso: nenhuma afirmação crítica fica sem referência, e cada referência abre, funciona e diz o que a página afirma que ela diz.
Etapa 4: como estruturar a página para ser lida por robôs?
Estrutura é a parte técnica do método, e muito dela coincide com boas práticas de SEO. Use títulos que descrevem o assunto, um tema por seção, tabelas para dados comparáveis e listas para itens enumeráveis. Mantenha o HTML semântico e o conteúdo principal presente no HTML entregue pelo servidor, sem depender de interação para aparecer. A anatomia completa está em anatomia de uma página citável.
Dados estruturados em JSON-LD entram quando descrevem o que a página já mostra: organização, pessoa, artigo, produto. O Google deixa claro que não há marcação especial exigida para os recursos de IA e que o marcado deve corresponder ao texto visível. A Microsoft, em orientação publicada em outubro de 2025, recomenda schema como apoio à interpretação, e diz que não há "fórmula secreta" que garanta seleção. A página schema e entidade mostra o que declarar e o que deixar de fora.
Confira o acesso. Verifique o robots.txt para os robôs de busca e de leitura sob demanda, o status HTTP, o canônico, o tempo de resposta e o que um robô sem JavaScript consegue ler.
Critério de sucesso: a página passa na leitura sem JavaScript, o schema é válido e coerente com o texto, e os robôs que você quer que a leiam não estão bloqueados.
Etapa 5: onde mais a informação precisa existir?
Nenhum sistema confia só na palavra da marca sobre si mesma. A quinta etapa leva a informação correta às fontes externas que a máquina já consulta e que a pessoa também leria: perfis oficiais em plataformas, diretórios do setor, Wikidata quando a entidade atende aos critérios de notoriedade, imprensa, publicações técnicas, comunidades de perguntas e respostas, repositórios e documentação de parceiros.
Aqui vale a regra de conduta mais importante do método: só se publica o que é verdadeiro, e só se participa onde a participação é legítima. Perfil falso, avaliação comprada, resposta disfarçada em fórum e rede de sites criada para citar a si mesma estão fora, por ética e por risco prático. O Google diz que buscar menções inautênticas não é tão útil quanto parece. A página de fontes externas lista tipos de fonte, o que cada uma exige e o que evitar.
Critério de sucesso: os fatos críticos coincidem, letra por letra quando possível, em todas as fontes externas controláveis, e há pelo menos uma fonte independente que os confirma.
Etapa 6: como medir e revisar?
A medição fecha o ciclo. Defina o conjunto fixo de perguntas da etapa 1, escolha as plataformas, rode a coleta em intervalos regulares e guarde resposta, fontes citadas, data e versão do modelo quando disponível. Avalie estes pontos: a marca aparece? A descrição está correta? As fontes citadas são as que você preparou ou outras?
Use também os dados que as plataformas entregam. O Google informa um relatório de desempenho de recursos de IA no Search Console. O Bing Webmaster Tools oferece um relatório de desempenho de IA com citações no Copilot e nos resumos do Bing. Os tráfegos de referência de assistentes aparecem em analytics com seus domínios de origem, com a ressalva de que parte das visitas chega sem referência identificável.
O método de Camillo para medir presença em respostas é o Citation Share. Neste site, o tema aparece em ROI sem clique. Revise o ciclo a cada trimestre ou quando mudar a página, a oferta ou a política de uma plataforma.
Critério de sucesso: série histórica com mesma lista de perguntas, resposta arquivada e decisão registrada para cada variação relevante.
Quanto tempo leva cada etapa?
Não há prazo universal, e quem promete um prazo para entrar em respostas de IA está prometendo algo que não controla. Para planejar o trabalho interno, uma estimativa de esforço é razoável para uma marca pequena ou média. A etapa 1 costuma ocupar uma semana de trabalho de uma pessoa. As etapas 2 a 4 dependem do número de páginas-chave. A etapa 5 depende de quantas fontes externas já existem. A etapa 6 é contínua. O roteiro de execução está em como começar em 30 dias.
Qual é o erro mais comum ao aplicar o método?
Pular a etapa 3. Muita gente reescreve a página com respostas diretas e depois não consegue provar nenhuma delas. Outro erro frequente é tratar a etapa 5 como um volume a produzir, em vez de uma consistência a garantir. Os dois estão detalhados em erros comuns.
Perguntas frequentes sobre o método
O método é uma sequência fixa ou pode ser feito fora de ordem?
A ordem reflete dependência: não há como provar o que ainda não se definiu, nem distribuir uma resposta que não existe. Em sites que já têm bom conteúdo, é comum começar pela auditoria da etapa 4 e voltar às demais. O que não funciona é pular a medição inicial, porque sem ela não se sabe o que mudou.
Quantas perguntas devo mapear na primeira rodada?
Entre 20 e 50 perguntas bastam para começar. O importante é que sejam reais, agrupadas por intenção e fixas ao longo do tempo. Uma lista muito grande atrasa a coleta e dilui a análise.
O método exige dados estruturados?
Não é obrigatório para que o Google use uma página nos recursos de IA, conforme a documentação dele. Dados estruturados coerentes ajudam a descrever entidades com precisão e podem apoiar outros sistemas, como o Bing, mas nunca substituem um texto claro e verificável.
Posso aplicar o método sozinho?
Pode. As etapas e os critérios foram escritos para que uma equipe pequena consiga executar e verificar o trabalho. Se preferir acompanhamento, Camillo oferece consultoria e análise estratégica no site pessoal.
Fontes
- Optimizing your website for generative AI features on Google Search, Google Search Central (2026-07-10)
- AI in Search: Going beyond information to intelligence, Google (2025-05-20)
- Optimizing Your Content for Inclusion in AI Search Answers, Microsoft Advertising (2025-10-08)
- Bing Webmaster Tools AI Performance Report, Adobe Experience League (2026-10-02)
- GEO: Generative Engine Optimization, Aggarwal et al., arXiv (KDD 2024) (2023-11-16)
Autoria do método: Camillo Dantas (declarada pelo autor). Última revisão: 14/10/2026.
Comece pelo checklist
Dezoito verificações em seis grupos para saber se o seu conteúdo pode ser compreendido, verificado e citado.